地端世界ONPREM WORLD

開發與客製化 AI 工作站

OnPrem Branch

給開發團隊的 AI 程式助手,也是訓練專屬 LLM 的地方。原始碼與資料永遠不出公司。

新的成果都從分支長出來,樹是這樣,git 也是。型號數字就是顯示記憶體的 GB 數。

OnPrem Branch
示意圖

給軟體團隊與要打造專屬 AI 的企業

它能幫團隊做什麼

編輯器即時補全在 VS Code 或 JetBrains 裡邊打邊給建議,透過 OpenAI 相容端點連接。
問你的程式庫解釋陌生的程式碼、找出邏輯在哪裡、補上缺少的文件。
AI 程式代理跨檔修改、重構與撰寫測試,交給可審查的 AI 代理。
程式審查每個 PR 在同事看之前,先有一雙 AI 的眼睛。
程式碼不外流原始碼、金鑰與客戶資料不會送到外部 AI 服務。
可商用模型採用 Apache-2.0 授權的 Qwen3-Coder 模型,產出的程式碼可放心商用。
訓練專屬 LLM用你的文件、術語、語氣與規則微調開源模型:Branch 32 可訓練 32B,Branch 96 可訓練 70B 到 120B。

依開發方式挑選

Branch 32 適合快速補全、問答與中型專屬模型;Branch 96 適合大型程式庫的 AI 代理與 70B 到 120B 的專屬模型。型號數字就是顯示記憶體的 GB 數。

OnPrem Branch 32
示意圖

OnPrem Branch 32

最多五位工程師的高速補全與程式問答,也能訓練中型專屬模型。

  • ✓ 可供最多 5 人同時使用。
  • ✓ 跑 Qwen3-32B,估計每秒約 30 個 token
  • ✓ 程式模型 Qwen3-Coder-30B-A3B-Instruct,32K 上下文下估計每秒約 193 個 token
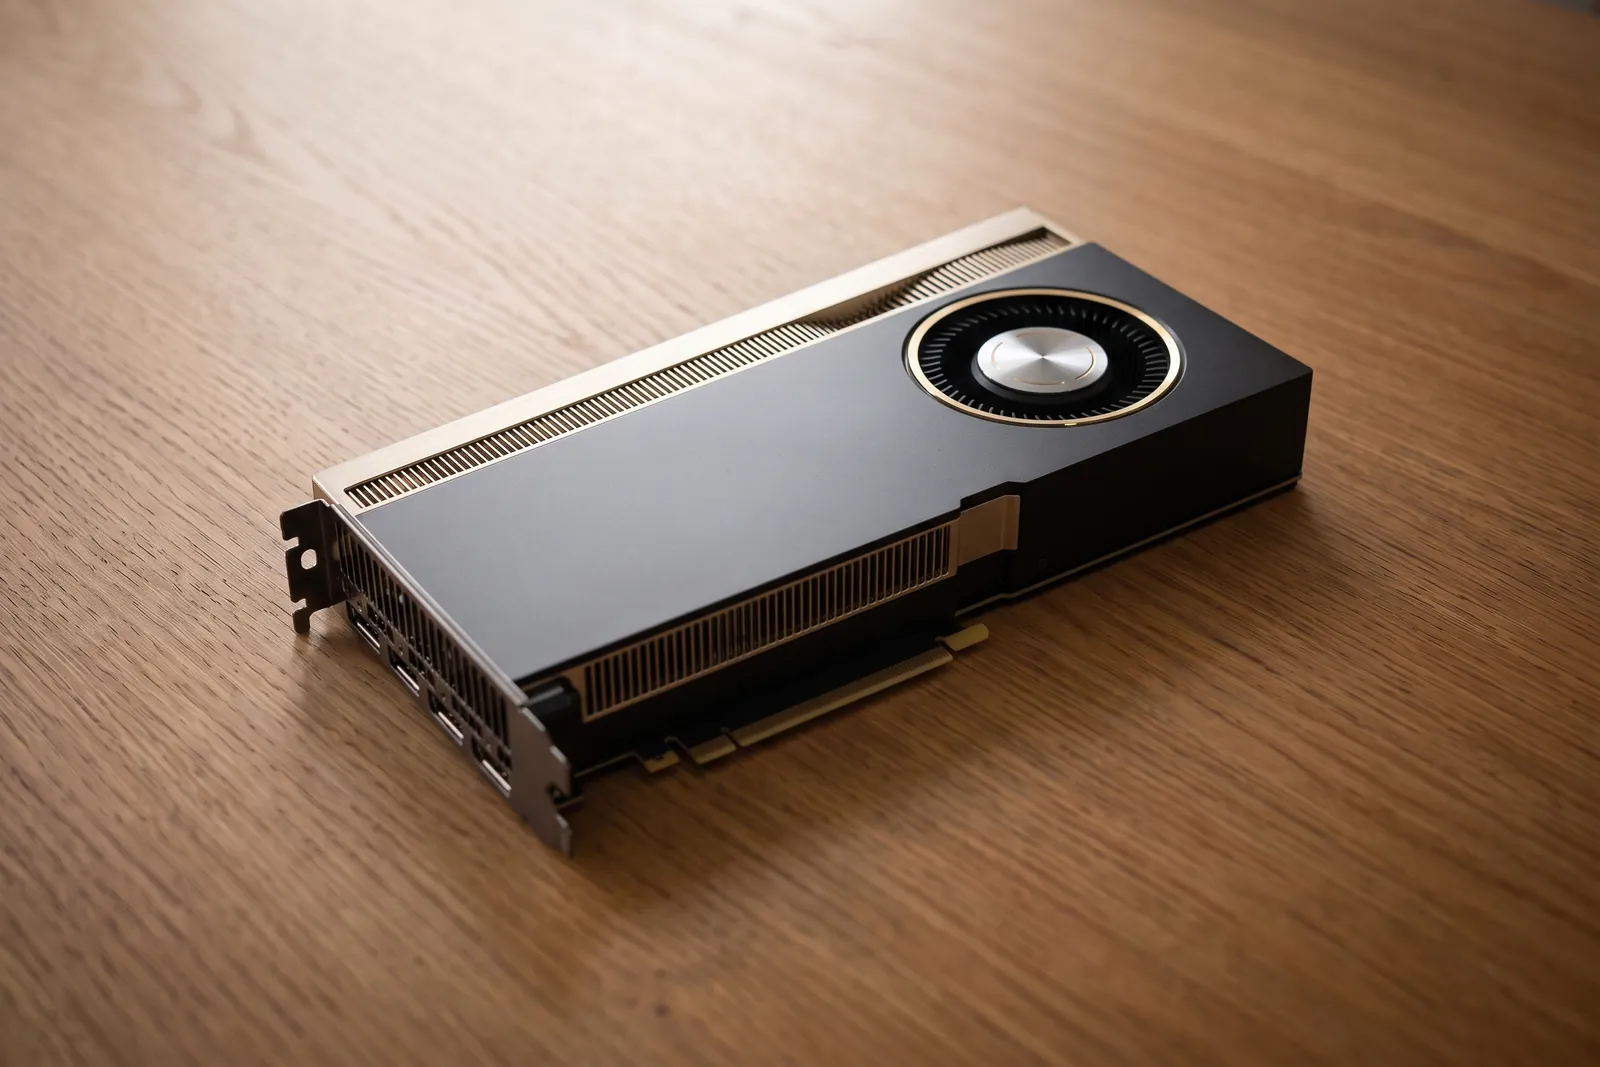
顯示卡NVIDIA RTX PRO 4500 Blackwell,32 GB(ECC),200 W
處理器Intel Core Ultra 9 285
記憶體128 GB DDR5
儲存2 TB NVMe
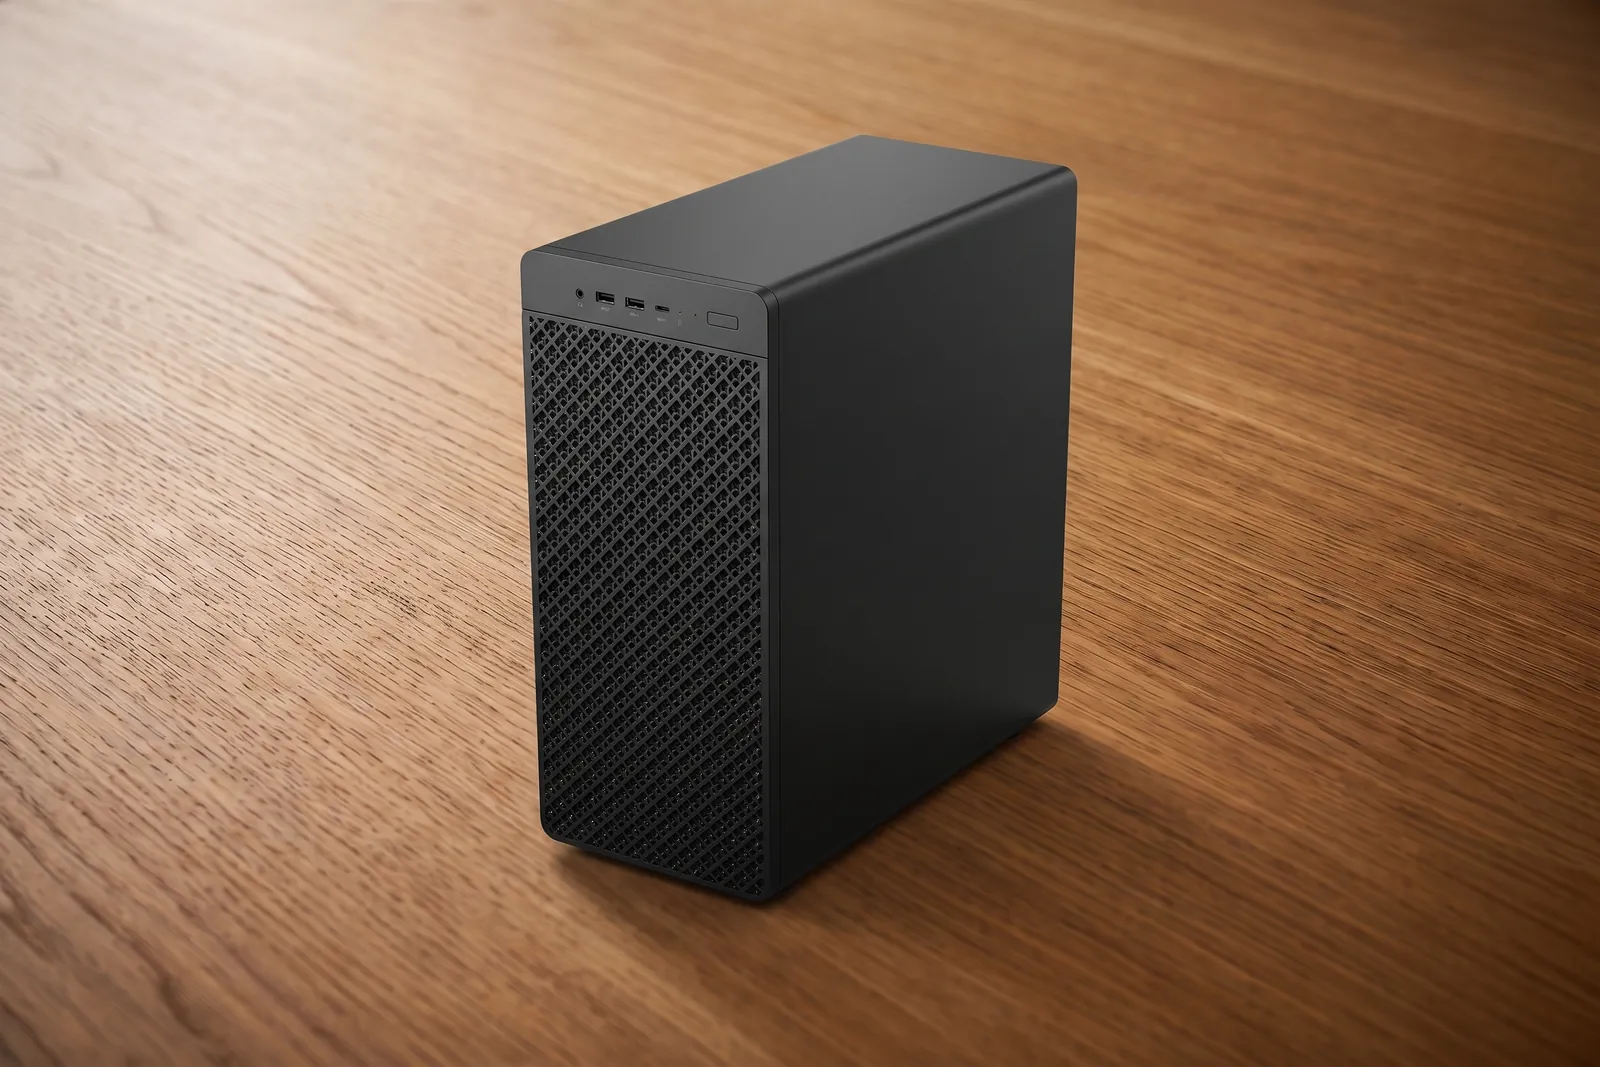
機身HP Z2 G1i 直立工作站
保固3 年保固,Ubuntu,提供 OpenAI 相容 API
看顯示卡規格 →
OnPrem Branch 96
示意圖

OnPrem Branch 96

最多二十位工程師的大型程式庫與 AI 代理,也能訓練 70B 到 120B 的專屬模型。

  • ✓ 可供最多 20 人同時使用。
  • ✓ 跑 Qwen3-32B,估計每秒約 56 個 token
  • ✓ 也能跑 ChatGPT 級的 gpt-oss-120b
  • ✓ 程式模型 Qwen3-Coder-30B-A3B-Instruct,32K 上下文下估計每秒約 278 個 token
  • ✓ 也能跑給 AI 程式代理用的 Qwen3-Coder-Next (80B-A3B)
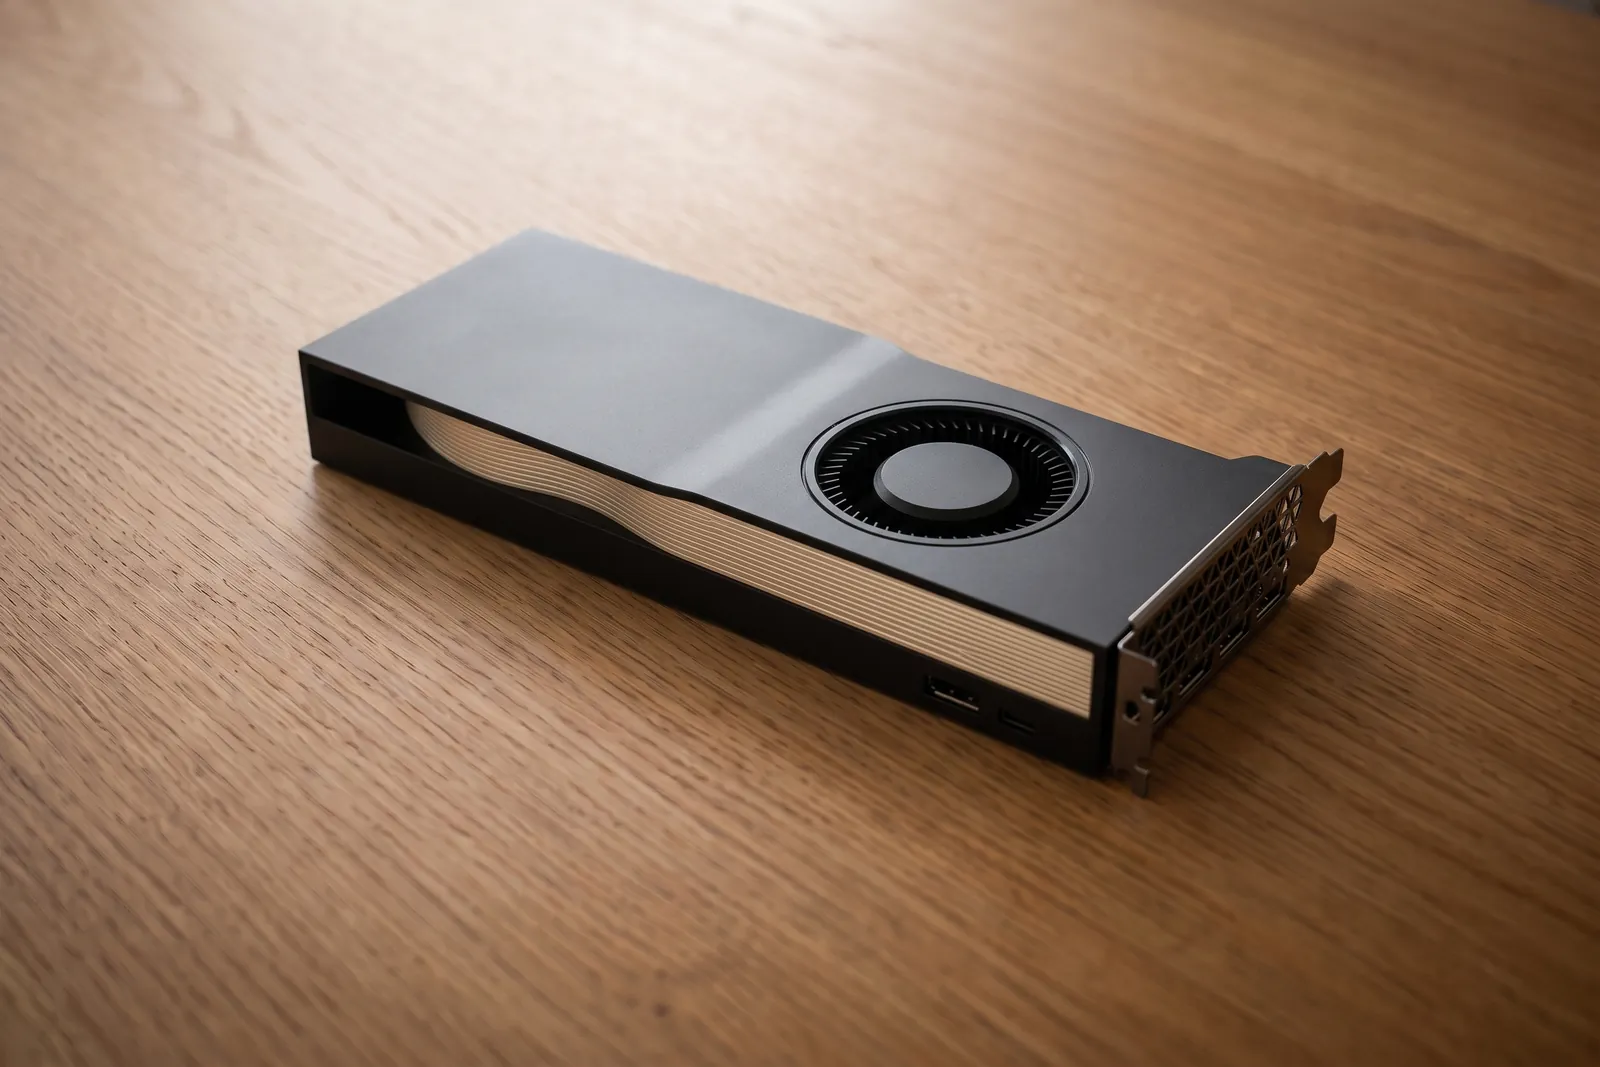
顯示卡NVIDIA RTX PRO 6000 Blackwell Max-Q,96 GB(ECC),300 W
處理器Intel Core Ultra 9 285
記憶體128 GB DDR5
儲存4 TB NVMe
機身HP Z2 G1i 直立工作站
保固3 年保固,Ubuntu,提供 OpenAI 相容 API
看顯示卡規格 →

價格依報價。我們會安裝軟體、到場架設並教你的團隊使用。 速度為估算值,並非實測。

我們安裝與設定的內容

常見問題

能用在我們的編輯器嗎?

可以。它提供 OpenAI 相容 API,VS Code 與 JetBrains 的程式外掛都能連接,我們會幫團隊設定好。

我們的程式碼會被拿去訓練嗎?

不會。所有運算都在你辦公室的機器上,什麼都不會送出去。

我們需要哪一台?

Branch 32 適合最多五位工程師做補全與問答;Branch 96 適合最多二十位,或要在大型程式庫上跑 AI 代理。

可以用我們自己的資料訓練模型嗎?

可以。微調 32B 模型約需 26 GB,70B 到 120B 需 41 到 65 GB(Unsloth 公布的最低需求),Branch 32 與 Branch 96 都涵蓋。我們會設定好工具,並和你一起交付第一個模型。

產生的程式碼可以商用嗎?

我們安裝的 Qwen3-Coder 模型採用 Apache-2.0 授權,允許商業使用。

不確定?讓小芽幫你配

跟小芽開始 →